企業導入 AI 之後,AI 成本最大的變數往往不是用量,而是選了哪個模型。
同一則客服問答,假設輸入約一萬個 token(系統提示、知識庫片段加上客戶的問題),輸出五百個 token。以企業 AI 平台 MaiAgent 的費率計算,用 GPT-6 Luna 回答約 25 Credits,換成 GPT-6 Astra 約 2,475 Credits,相差 100 倍。
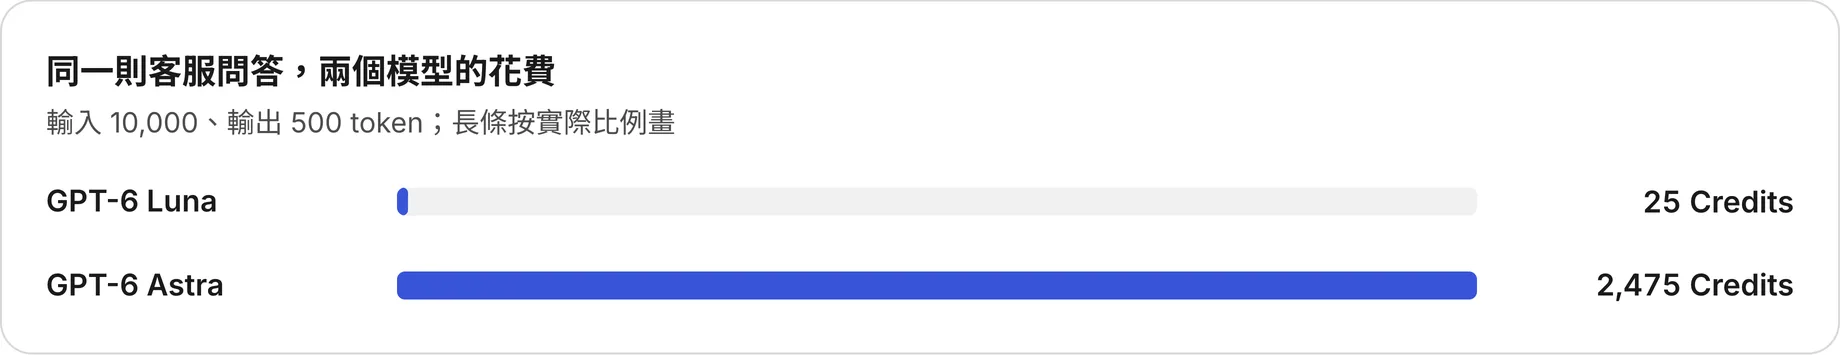
如果企業一個月要回答幾萬則問題,預算就會差到兩個數量級。但貴不等於好,MaiAgent 上架、有公開能力分數的 45 個文字模型裡,有 39 個都找得到另一個更便宜、能力也不輸的選擇。
也可以先看這支 2 分鐘的影片版。
一、AI 成本怎麼算?LLM 的費用看輸入與輸出
1. LLM 費用的計算方式
大型語言模型按 token 計費,輸入和輸出分開算。每次呼叫模型扣的 Credits,算法如下。
Credits = 輸入 token ÷ 100 萬 × 輸入單價 + 輸出 token ÷ 100 萬 × 輸出單價
以 GPT-6 Luna 為例,每 100 萬 token 的輸入單價是 1,980 Credits、輸出單價是 9,900 Credits,一則輸入 10,000、輸出 500 token 的客服問答,就是 19.8 加 4.95,約 25 Credits。各模型的輸入、輸出單價公開在 Credits 計費制度。
2. 三筆常被低估的 AI 成本
公式很單純,但有三筆費用常被低估。
常被低估的費用 | 為什麼 |
|---|---|
輸出比輸入貴 | 多數模型的輸出單價是輸入的 5 倍,回答越長越貴;開啟思考模式時,模型內部推理的 token 也按輸出計費 |
上下文每次都要重送 | 系統提示、工具定義、知識庫片段和對話歷史每次呼叫都要重送,Agent 每呼叫一次工具就重送一次。觀察 2026 年 10 月兩週的平台資料,上下文超過四萬 token 的訊息只佔 23%,卻用掉 62% 的 token |
搜尋結果重排序 | 知識庫若開啟這項功能,每次檢索另加約 40 Credits,比便宜模型回答一次還貴 |
不過影響 AI 成本最大的,還是選哪個模型。
二、LLM 比較,貴的模型不一定比較好
1. 模型的效率前緣是什麼
效率前緣的意思是,在花費一樣或更少的模型裡,能力最強的那幾個。不在效率前緣上的模型,一定找得到另一個更便宜、能力也不輸的替代。
下圖把每個模型畫成一個點,橫軸是一次問答的 Credits 花費,縱軸是 Epoch AI 的能力指數(ECI),資料與 MaiAgent 管理後台的散佈圖相同。
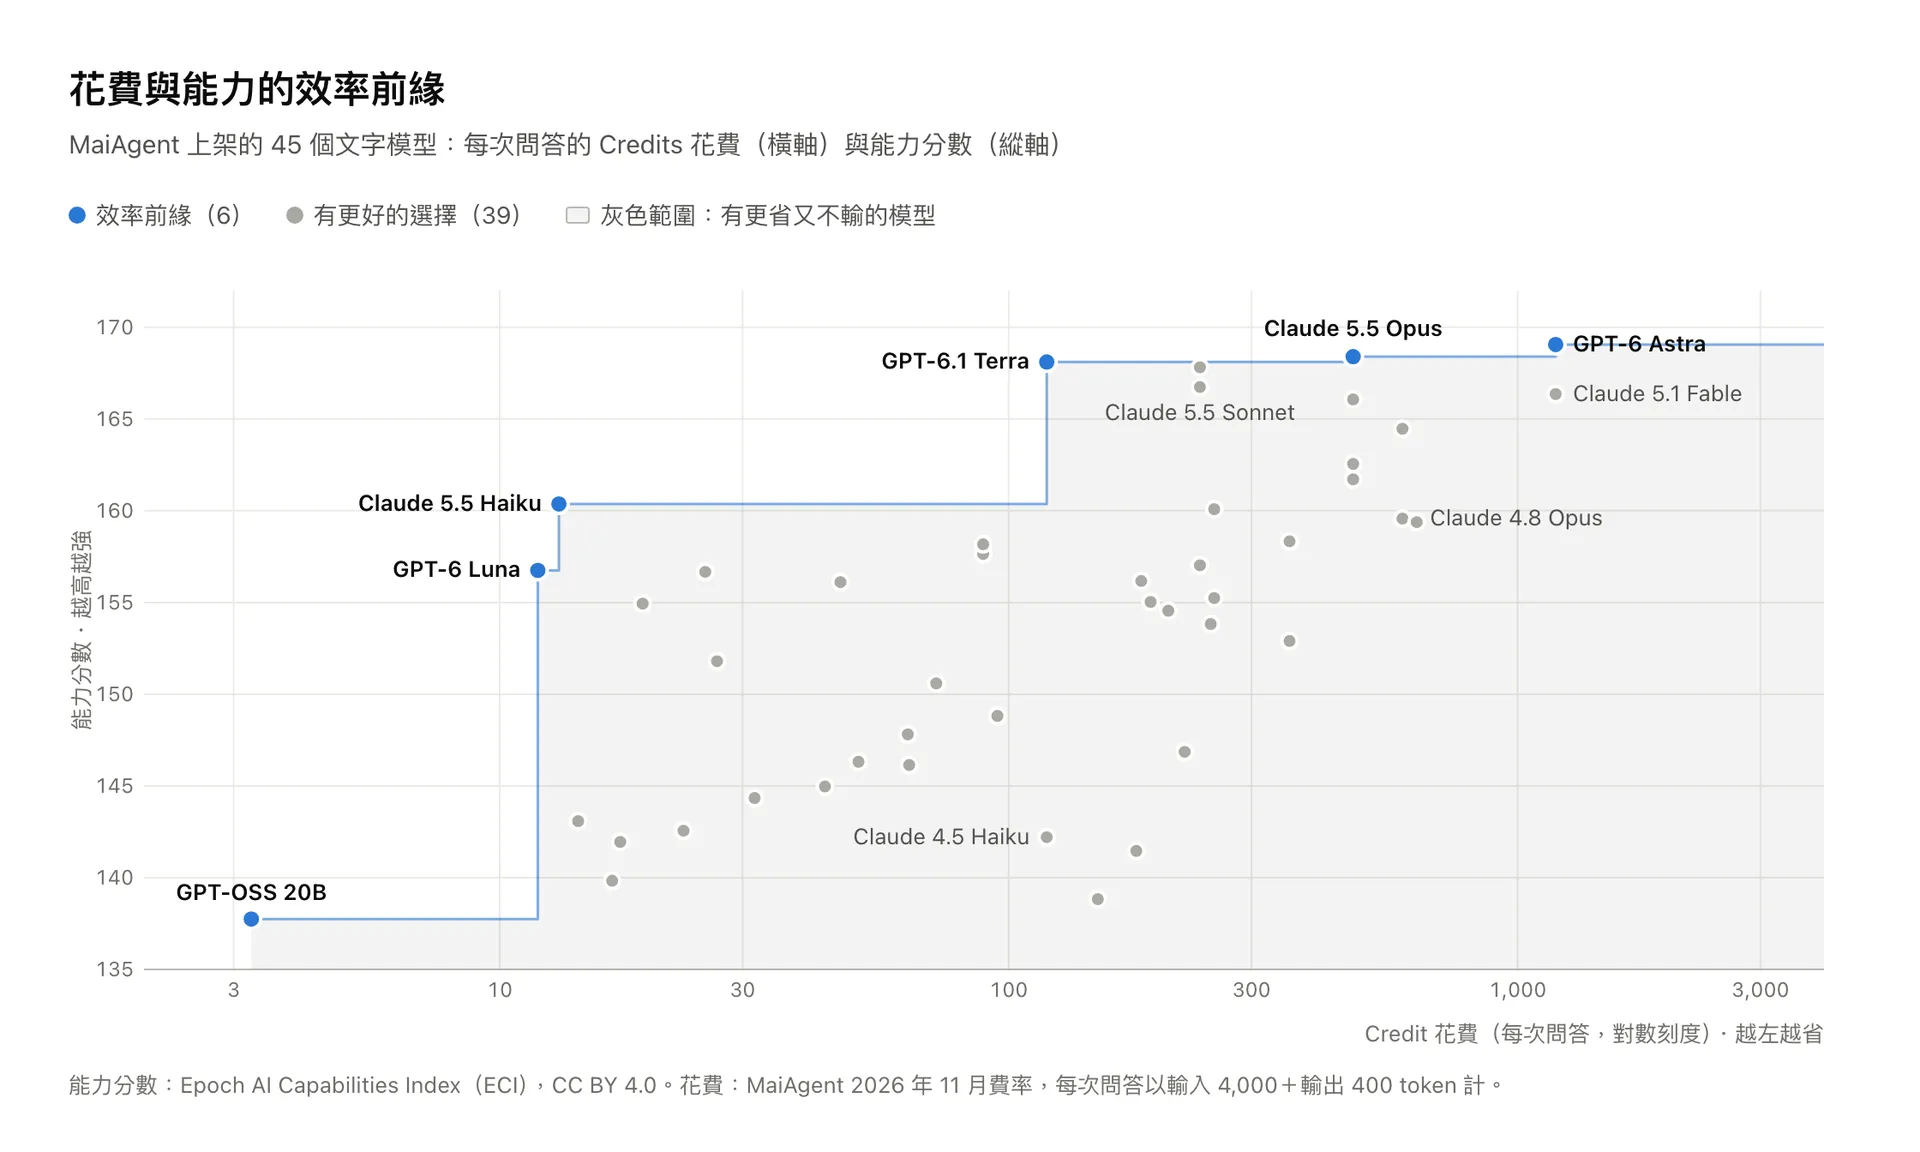
45 個模型裡,只有 6 個在效率前緣上。幾個例子可以看出貴不等於好。
GPT-6.1 Terra 的能力分數 168.1,跟 Claude 5.5 Opus(168.4)只差 0.3 分,花費只要四分之一;它也比 Claude 5.5 Sonnet、GPT-6.1 Sol 便宜一半,分數還更高。
Claude 5.1 Fable 的花費是 Claude 5.5 Opus 的 2.5 倍,分數反而低 2 分。
Claude 5.5 Haiku 分數 160.4,已經高過 2026 年 5 月的旗艦 Claude 4.8 Opus(159.6),花費只有它的 1/45。
模型的價格和能力變得很快,比多數企業更新設定的速度快得多。
2. 目前最划算的模型
選模型時依任務難度往上選,每一級挑效率前緣上的模型。下表以 2026 年 11 月的費率計算,一則客服問答以輸入 10,000、輸出 500 token 估算。
模型 | 定位 | 能力 | 每則客服問答 | 每 100 萬 | 適合 |
|---|---|---|---|---|---|
GPT-6 Luna | 輕量 | 156.8 | 25 | 約 4 萬則 | 大量客服 FAQ、摘要、分類 |
Claude 5.5 Haiku | 輕量 | 160.4 | 27 | 約 3.7 萬則 | 同上,分數更高 |
GPT-6.1 Terra | 中階 | 168.1 | 248 | 約 4,000 則 | 多步工具呼叫、長文件分析 |
Claude 5.5 Opus | 旗艦 | 168.4 | 990 | 約 1,000 則 | 最難、價值最高的任務 |
GPT-6 Astra | 旗艦 | 169.1 | 2,475 | 約 400 則 | 少量關鍵任務 |
以專業版每月 500 萬 Credits 計算,全用 GPT-6 Luna 約可回答 20 萬則客服問答,全用 GPT-6 Astra 只有約 2,000 則;企業版每月 1,000 萬 Credits,次數加倍。
三、AI 成本怎麼降低?先分層,再談省
1. 依任務難度分層選模型
降低 AI 成本最直接的做法是分層。大量、規則明確的問答交給輕量模型,需要多步推理、跨系統操作的 Agent 才用中階或旗艦。同一份額度,輕量模型能回答的次數是旗艦的幾十到一百倍。
2. 選定模型之後還能省的地方
模型選定之後,同一個模型也還有省的空間,例如縮短每次重送的上下文、善用提示快取、調整思考強度。
想把這些節省換算成投資報酬,或了解推論成本下降對採購策略的影響,可以接著讀這兩篇。
延伸閱讀:〈AI 導入的 ROI 怎麼算?〉、〈DeepSeek 衝擊:企業 AI 採購策略要改變了嗎?〉
四、AI 成本試算,算算你的用量
下表列出三種常見用法下,各模型每次的 Credits 花費。用每月的 Credits 額度除以每次花費,就是一個月能用幾次,例如專業版每月 500 萬 Credits,用 GPT-6 Luna 回答客服問答約可用 20 萬次。
五、LLM 價格下降多快?同等能力的模型便宜了幾百倍
1. 同樣的能力,價格一路往下掉
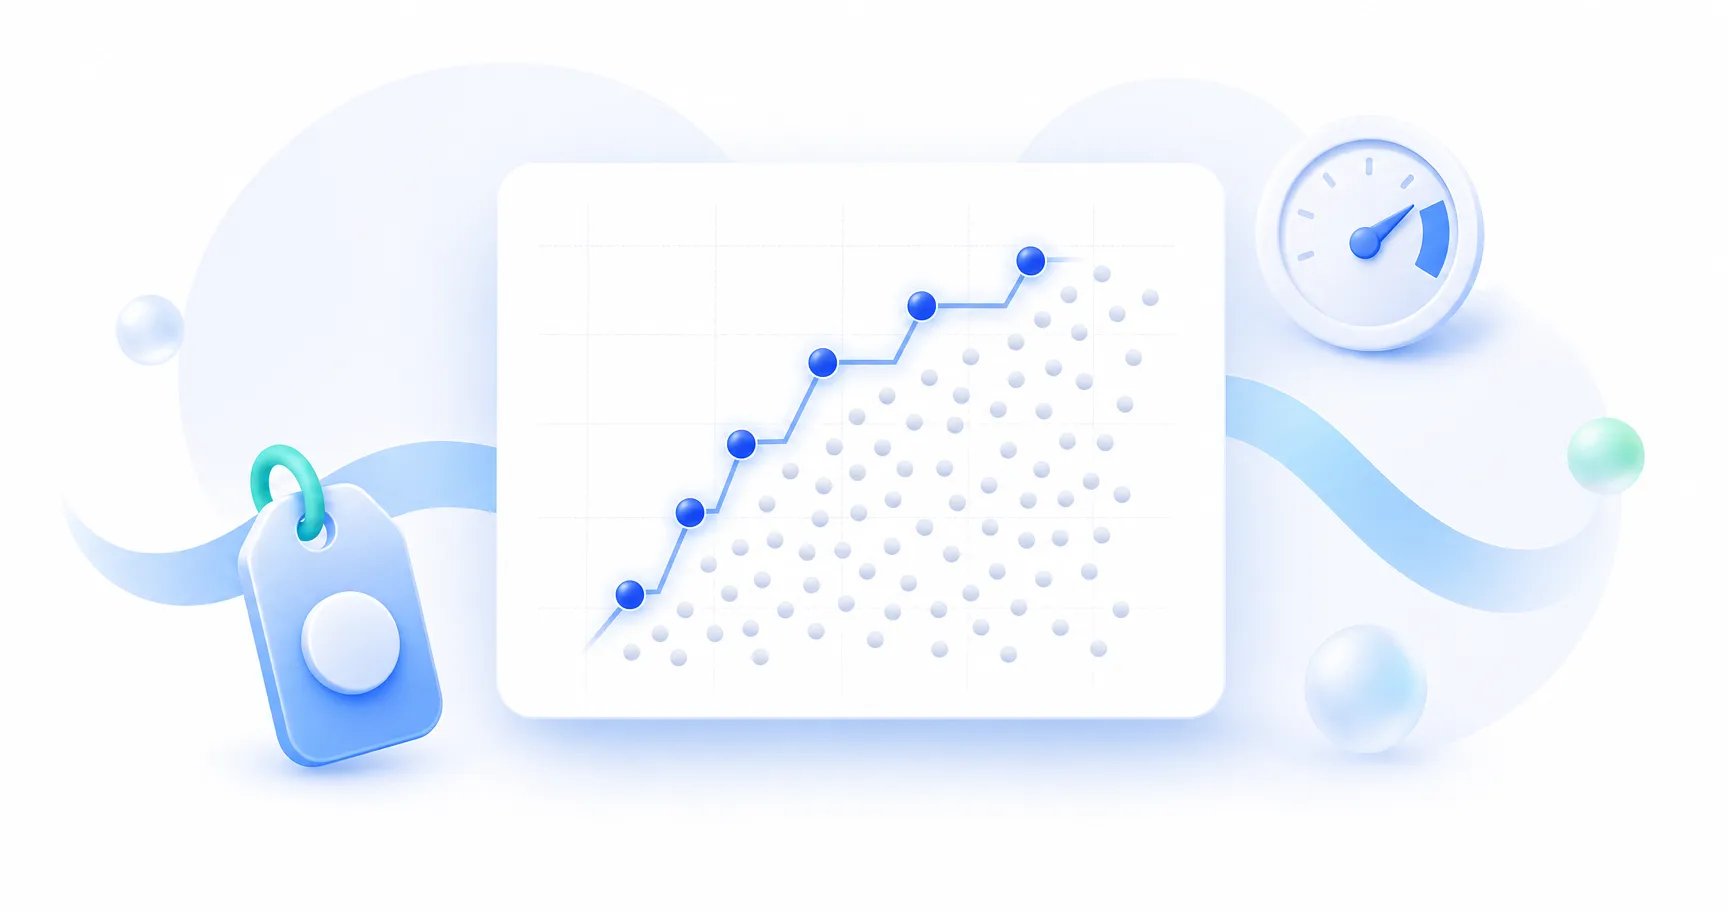
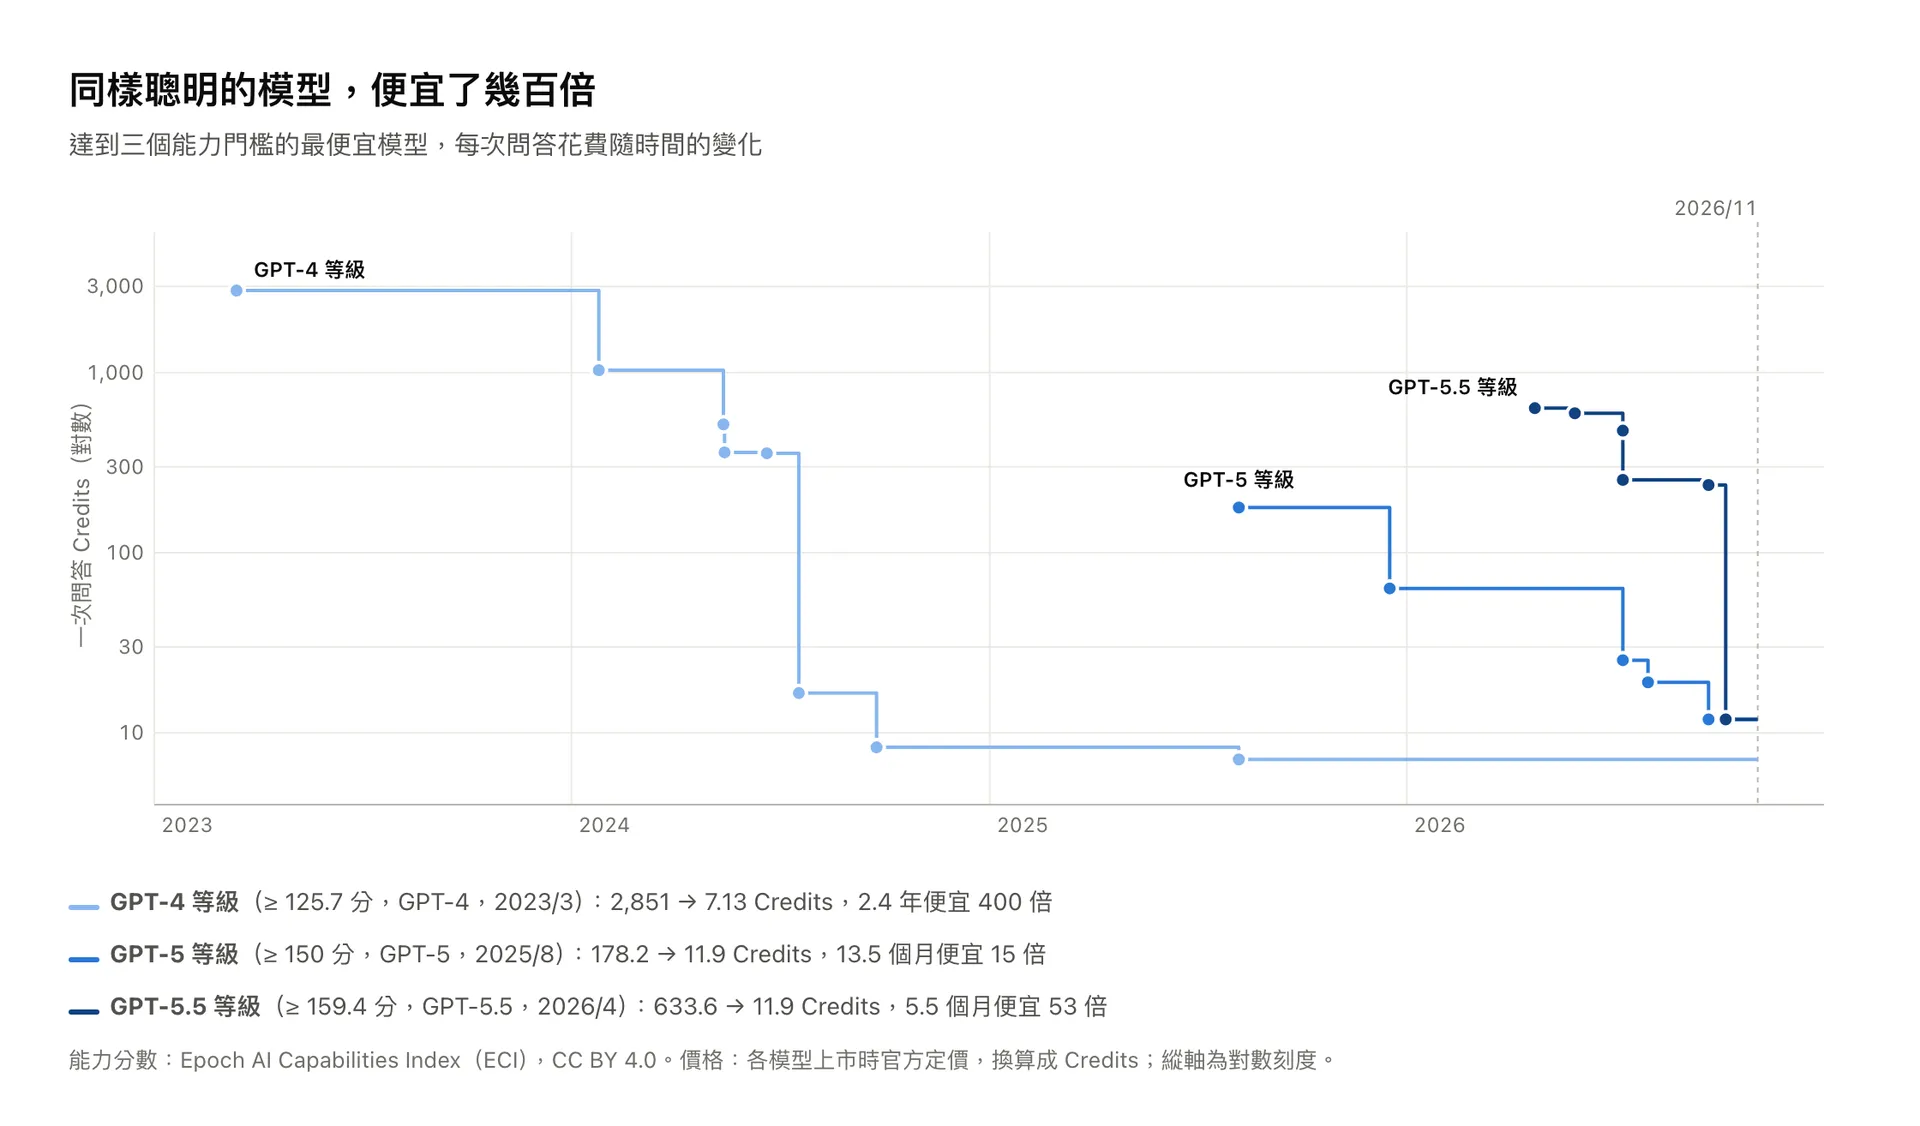
把能力分數固定,看每個時間點達到這個分數的最便宜模型要花多少,趨勢更清楚。下圖用各模型上市時的官方定價,換算成每次問答的 Credits。
能力等級 | 起點花費 | 最低花費(上市定價) | 變化 |
|---|---|---|---|
GPT-4 等級(≥ 125.7 分) | 2,851 Credits(GPT-4,2023/3) | 7.13 Credits | 2.4 年便宜 400 倍 |
GPT-5 等級(≥ 150 分) | 178.2 Credits(GPT-5,2025/8) | 11.9 Credits | 13.5 個月便宜 15 倍 |
GPT-5.5 等級(≥ 159.4 分) | 633.6 Credits(GPT-5.5,2026/4) | 11.9 Credits | 5.5 個月便宜 53 倍 |
越新的能力等級降得越快。GPT-5.5 等級在 2026 年 4 月只有 GPT-5.5 做得到,半年後 Claude 5.5 Haiku 就達到了。
外部研究看到的是同樣的趨勢。Epoch AI 量測六個基準,發現達到固定分數的價格每年下降 9 到 900 倍;a16z 把這個現象稱為 LLMflation,估計同等能力每年便宜約 10 倍。
2. 大降價多半來自新的輕量模型
大降價通常不是舊模型降價,而是新的輕量模型出現。2024 年 7 月 GPT-4o mini 一次把 GPT-4 等級的成本拉低 21 倍;2026 年 10 月 Claude 5.5 Haiku 把 GPT-5.5 等級的成本一次拉低 20 倍。所以今天選定的模型,半年內很可能出現更便宜的同級替代。
3. 開源模型與地端部署
開源模型也跟上了。GPT-OSS 20B 是能在單張 GPU 上執行的開源模型,能力分數 137.8,已經超過 2023 年的 GPT-4,這也是地端部署越來越可行的原因。
六、換模型前怎麼驗證?用自己的考題重測
1. 能力分數高,不代表在你的場景表現更好
模型要定期換,但換之前要先驗證。能力分數更高,不代表在你的知識庫、你的客戶問題上表現更好,回應速度、格式和語氣也可能改變。我們遇過換了模型沒先測、回應時間反而變慢的情況,也有客戶把近 300 題考題重跑一次後,決定先不換。
延伸閱讀:〈AI 模型更迭快過企業導入的速度,怎麼跟得上?關鍵在多模型切換〉
2. MaiAgent Serve 換模型的固定流程
MaiAgent Serve 的營運服務把換模型做成固定流程,每一步都有紀錄。
新模型推出
用你的考題重跑
交新舊比較報告
你同意才切換
切換後持續監看
地端部署的客戶,換模型由 Model Care 負責。
結語
AI 成本的關鍵,在於每件工作都用夠用又划算的模型。先依任務難度分層,每一級挑效率前緣上的模型,再用自己的考題確認實際表現。模型的價格和能力還會繼續變化,定期重新評估,才能讓同一份預算持續發揮最大的效益。
常見問題
最便宜的模型夠用嗎?
看任務。客服 FAQ、摘要、分類這類有明確答案的工作,輕量模型通常就夠用,例如 Claude 5.5 Haiku 的能力分數已經高過 2026 年 5 月的旗艦 Claude 4.8 Opus。需要多步推理、跨系統操作的 Agent,再往中階或旗艦升級。最可靠的判斷方式,是用自己的考題實測。
能力分數可以直接代表回答品質嗎?
不能完全代表。Epoch AI 的能力指數(ECI)綜合多項基準測試,適合用來比較模型的整體能力,但語言、格式要求和知識庫內容都會影響實際表現,上線前仍要用自己的考題驗證。
換模型會讓 Agent 的回答變差嗎?
有可能。新模型的語氣、格式、工具呼叫習慣都可能和舊模型不同,所以換之前要先用同一套考題重新測試,確認沒有退步再切換。
地端部署也適用這些數字嗎?
不適用。地端部署不按 token 扣 Credits,成本主要是 GPU 硬體與維運,可用的模型也以開源模型為主。
參考資料
Epoch AI,Epoch Capabilities Index(ECI),CC BY 4.0,2026 年 11 月查詢。
Epoch AI,LLM inference prices have fallen rapidly but unequally across tasks,2025 年 3 月。
a16z,Welcome to LLMflation – LLM inference cost is going down fast。
MaiAgent 說明文件,Credits 計費制度。
計算方式採 2026 年 11 月 MaiAgent 正式區的 Credits 基本費率,不含平台處理費。客服問答以輸入 10,000、輸出 500 token 計;效率前緣圖的每次問答以輸入 4,000、輸出 400 token 計,與 MaiAgent 後台一致;歷史價格為各模型上市時的官方定價,換算成 Credits。